RAG in de praktijk: een AI die écht jouw
bedrijfsdocumenten begrijpt
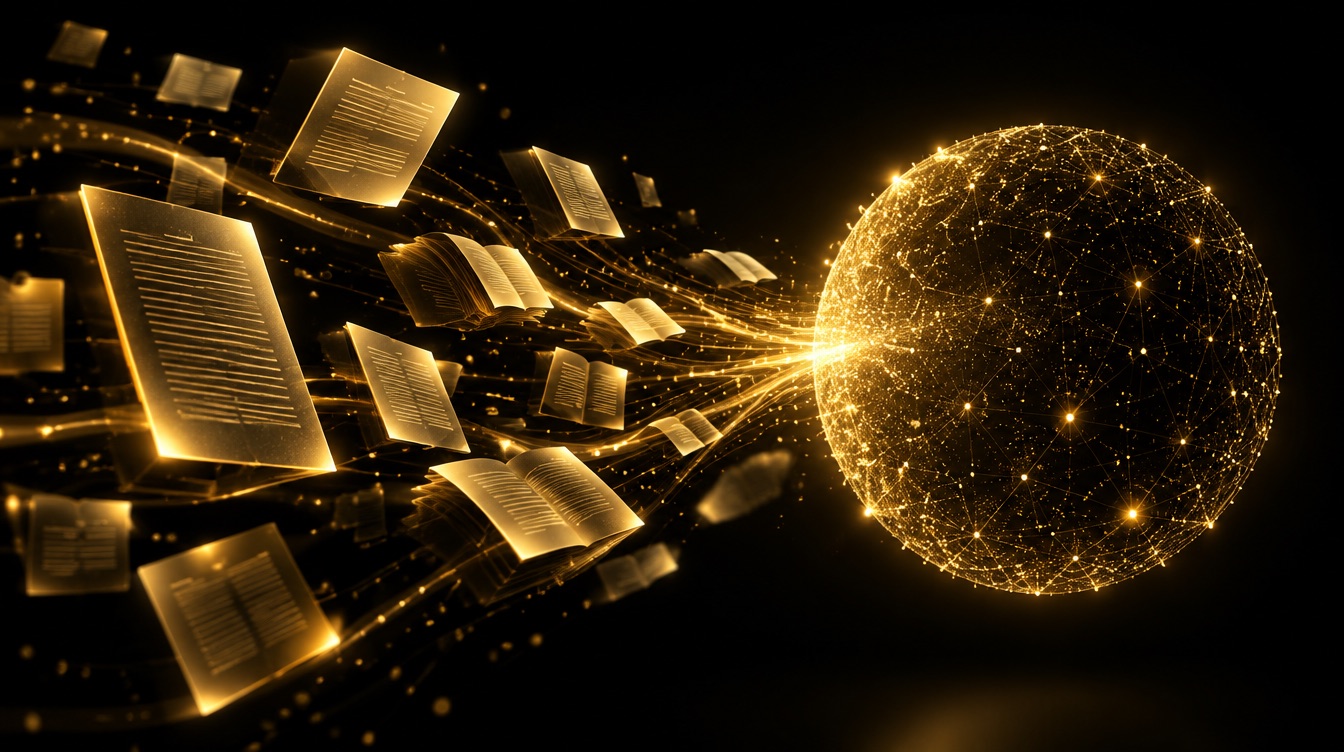
Retrieval-Augmented Generation is de technologie achter AI die antwoord geeft op basis van jouw eigen data. Geen hallucinaties, geen vage antwoorden — alleen relevante informatie uit jouw kennisbank. We leggen uit hoe het werkt en wanneer het zinvol is.
Het probleem met standaard AI
Wanneer je een AI-model vraagt naar jouw specifieke producten, interne procedures of klantcontracten, gebeurt er één van twee dingen: het model verzint iets dat plausibel klinkt maar incorrect is, of het geeft aan het antwoord niet te weten.
Beide zijn onbruikbaar in een professionele context. Het eerste is actief gevaarlijk — een medewerker of klant die vertrouwt op een gefabriceerd antwoord.
RAG lost dit op door het model niet te laten gissen, maar te laten zoeken.
"Een RAG-systeem weet wat het niet weet — en zoekt het op voordat het antwoord geeft."
Hoe RAG technisch werkt
De architectuur bestaat uit twee fases: indexering en retrieval. Eenvoudig uitgelegd:
Wanneer is RAG zinvol voor jouw bedrijf?
Niet elk AI-project heeft RAG nodig. Het is zinvol wanneer je één of meer van het volgende herkent:
- Interne kennisbank — medewerkers moeten vaak zoeken in handleidingen, procedures of contracten. Een RAG-systeem maakt dit conversationeel en direct.
- Klantenservice met productkennis — een chatbot die vragen beantwoordt op basis van jouw actuele productdocumentatie, niet op basis van wat het model "denkt" dat jij verkoopt.
- Juridische of financiële documenten — contracten, offertes, compliance-documenten doorzoekbaar maken zonder ze handmatig te lezen.
- Frequente updates — jouw data verandert regelmatig. RAG laat je de kennisbank bijwerken zonder het model opnieuw te trainen.
De kwaliteit zit in de details
Een RAG-systeem bouwen is technisch haalbaar in een dag. Een RAG-systeem bouwen dat betrouwbaar werkt, is een ander verhaal.
De kwaliteit wordt bepaald door hoe je de documenten opdeelt, welk embedding-model je gebruikt, hoe je de retrieval-stap optimaliseert en hoe je het taalmodel instrueert om eerlijk te zijn over zijn grenzen. Dit zijn de details die het verschil maken tussen een systeem dat indruk maakt in een demo en een systeem dat dagelijks productief gebruikt wordt.
Wij bouwen uitsluitend het tweede.
Een kennisbank laten bouwen?
Wij bouwen RAG-systemen die werken met jouw bestaande documenten — van technische specificatie tot productierijp systeem.
Vraag een gesprek aan